Het was een doodgewone dinsdagavond. Kentekendata van de XM en C6 stond netjes op de site, ik was tevreden, en dacht: laat ik nog even kijken wat er allemaal beschikbaar is bij RDW aan open data. Brandstofinformatie, dacht ik — dat zou een mooie aanvulling zijn. Verbruik, uitstoot, motorvarianten, dat soort dingen.
Ik klik door naar de dataset. Scroll naar beneden voor het aantal regels.
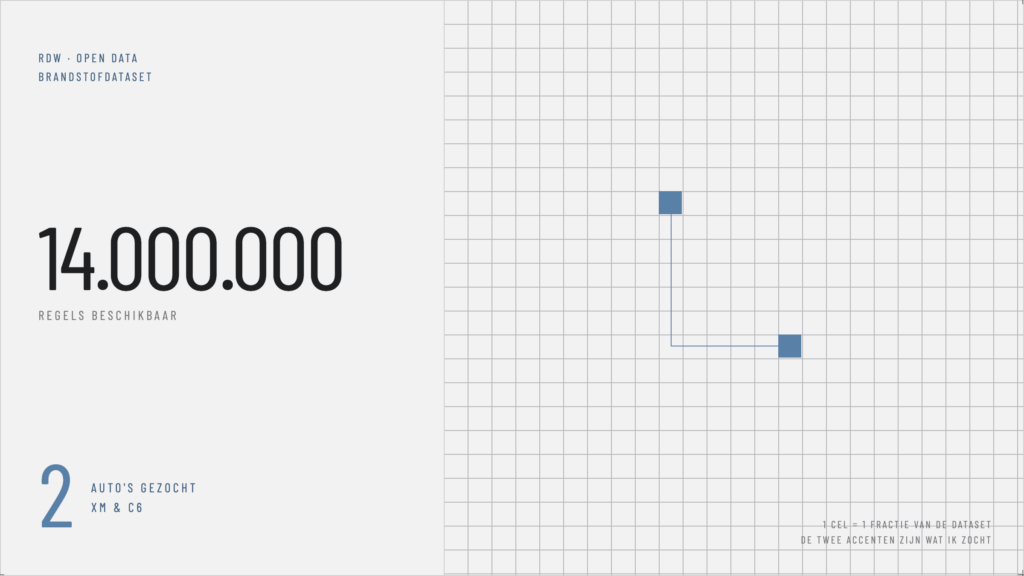
14.000.000.
Ik heb er letterlijk even naar zitten staren. Niet omdat het een schokkend getal is op zich — RDW heeft wel vaker forse datasets — maar omdat het zo overduidelijk niet paste bij wat ik eigenlijk wilde: twee auto’s. Twéé. En de dataset die daarvoor moest zorgen, was gebouwd voor heel Nederland.
Dat is het moment waarop een “leuk uitbreidingsklusje” plotseling een heel ander project wordt.
De bibliotheek
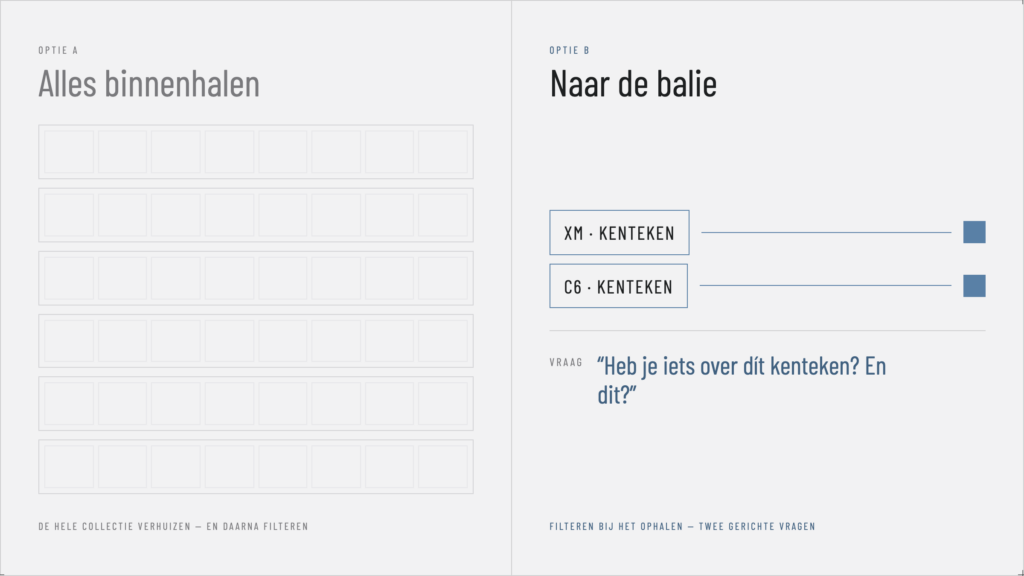
De vergelijking die bleef hangen: het voelde alsof ik een complete bibliotheek zou moeten kopen om één bepaald boek te kunnen lezen. Alle veertien miljoen regels binnenhalen, lokaal opslaan, en dan pas filteren op mijn twee kentekens — dat kán, maar het is een beetje absurd. Je haalt de hele collectie binnen voor twee titels die je al kent.
Gelukkig hoeft dat niet. RDW’s open data laat toe om al bij het ophalen te filteren, in plaats van pas erna. In bibliotheektermen: in plaats van de hele bibliotheek te verhuizen, loop je gewoon naar de balie en vraag je gericht om de twee boeken die je nodig hebt. Simpel gezegd — maar het verandert wel hoe je het hele ophaalproces bouwt. Geen grote, logge download meer, maar een gerichte, herhaalde vraag: “heb je iets over dit kenteken? En dit? En dit?”
Eén boek, meerdere hoofdstukken
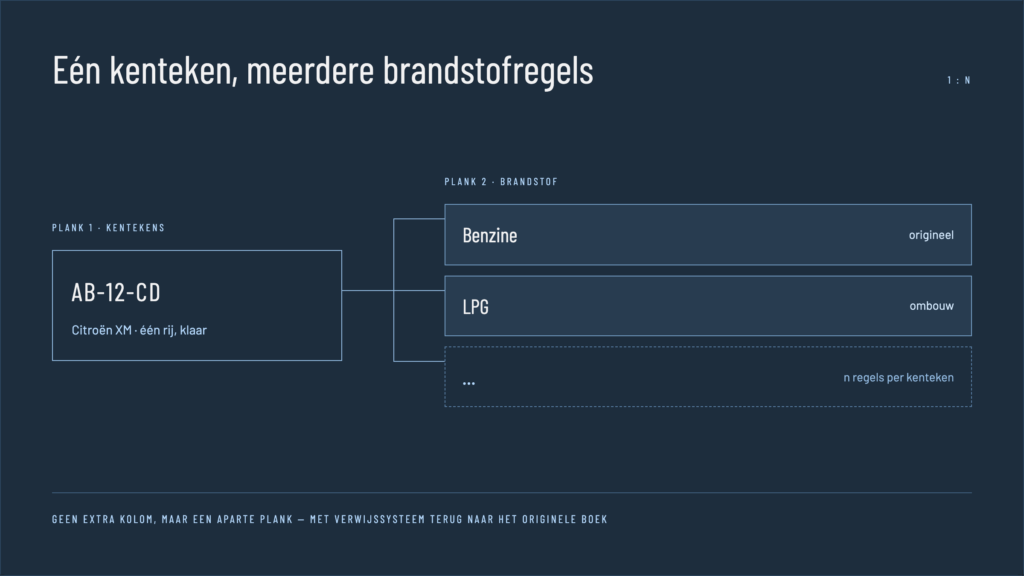
Net toen ik dacht dat ik het probleem had opgelost, bleek de bibliotheek nóg een eigenaardigheid te hebben. Bij de kentekendata was ik gewend aan overzichtelijke losse boeken: één kenteken, één rij, klaar. Bij brandstof werkt dat niet zo. Eén auto kan namelijk meerdere brandstofregels hebben — een LPG-ombouw naast de originele benzinemotor, bijvoorbeeld, of een hybride met twee brandstofsoorten tegelijk.
Met andere woorden: sommige van die twee boeken die ik kwam ophalen, bleken eigenlijk meerdelige naslagwerken te zijn. Dat verandert hoe je het uiteindelijk opbergt — je kunt dit niet zomaar als extra kolom in de bestaande tabel proppen. Er is een aparte plank nodig, met een duidelijk verwijssysteem terug naar het originele boek.
De catalogus klopt niet altijd
Iets waar ik bij een klein setje auto’s nooit tegenaan was gelopen, dook nu wél op: klopt de catalogisering eigenlijk wel tussen de twee bibliotheken?
Kentekens worden namelijk niet altijd overal exact hetzelfde geschreven — met of zonder streepjes, historische wijzigingen, eigenaarswissels. Bij twee auto’s val je dat nauwelijks op. Maar bij een bevraging van een dataset van deze omvang is de kans groot dat er ergens een verkeerd label op de plank hangt. Dus voordat ik enthousiast conclusies ga trekken uit mooie grafiekjes, wil ik eerst weten: vind ik daadwerkelijk een match voor elk kenteken, en waar loopt het mis als dat niet zo is?
Saai bibliotheekwerk, maar het soort saaie werk dat je later een hoop verwarring bespaart.
Twee balies, één systeem
Er is nog een laatste ding dat ik niet over het hoofd wilde zien: de kentekendata wordt al periodiek ververst vanuit mijn eigen sync-proces. Nu komt er een tweede bibliotheek bij die eigenlijk in de pas moet lopen met de eerste. Komt er een nieuw kenteken bij? Dan wil ik dat de bijbehorende brandstofinformatie er automatisch achteraan komt — niet twee balies die niets van elkaar weten en waarbij ik zelf moet onthouden om ze allebei langs te gaan.
Een klein architectuurvraagstuk, verstopt in wat op het eerste gezicht een simpel “erbij plakken”-klusje leek.
Waar dit heen gaat
Het uiteindelijke doel is niet ingewikkeld: ik wil straks kunnen laten zien hoe de brandstofsamenstelling van de XM- en C6-populatie eruitziet. Hoeveel zijn er ooit omgebouwd naar LPG? Verschuift dat door de jaren heen? Is er een patroon te zien tussen bouwjaar en brandstofkeuze?
Maar voordat die grafiekjes er staan, moet de bibliotheek eerst op orde zijn: gericht opvragen in plaats van alles binnenhalen, een systeem dat meerdelige werken aankan, een check op de catalogus, en twee balies die elkaar eindelijk verstaan.
De volgende keer laat ik zien hoe die balie er in de praktijk uitziet — welke vraag ik precies stel aan RDW, hoe de plank is ingericht, en of de catalogus inderdaad zo rommelig blijkt als ik vrees. Spoiler: helemaal netjes wordt het niet.